

Explicação: Como a Regularização L1 seleciona recursos automaticamente?
Entenda o processo de seleção automática de recursos realizado pela Regularização L1 (LASSO).
A seleção de recursos é o processo de selecionar um subconjunto ideal de recursos de um determinado conjunto de recursos; O subconjunto ideal é aquele que maximiza o desempenho do modelo na tarefa dada.
A seleção de características pode ser um processo manual ou, mais precisamente, explícito quando realizada por meio de métodos de filtragem ou de agrupamento . Nesses métodos, as características são adicionadas ou removidas repetidamente com base em um valor métrico fixo, que determina a importância da característica na realização de previsões. Essas métricas podem ser ganho de informação, variância ou a estatística qui-quadrado, e o algoritmo decide se aceita ou rejeita uma característica com base em um limiar fixo para a métrica. É importante observar que esses métodos não fazem parte da fase de treinamento do modelo e são executados previamente.
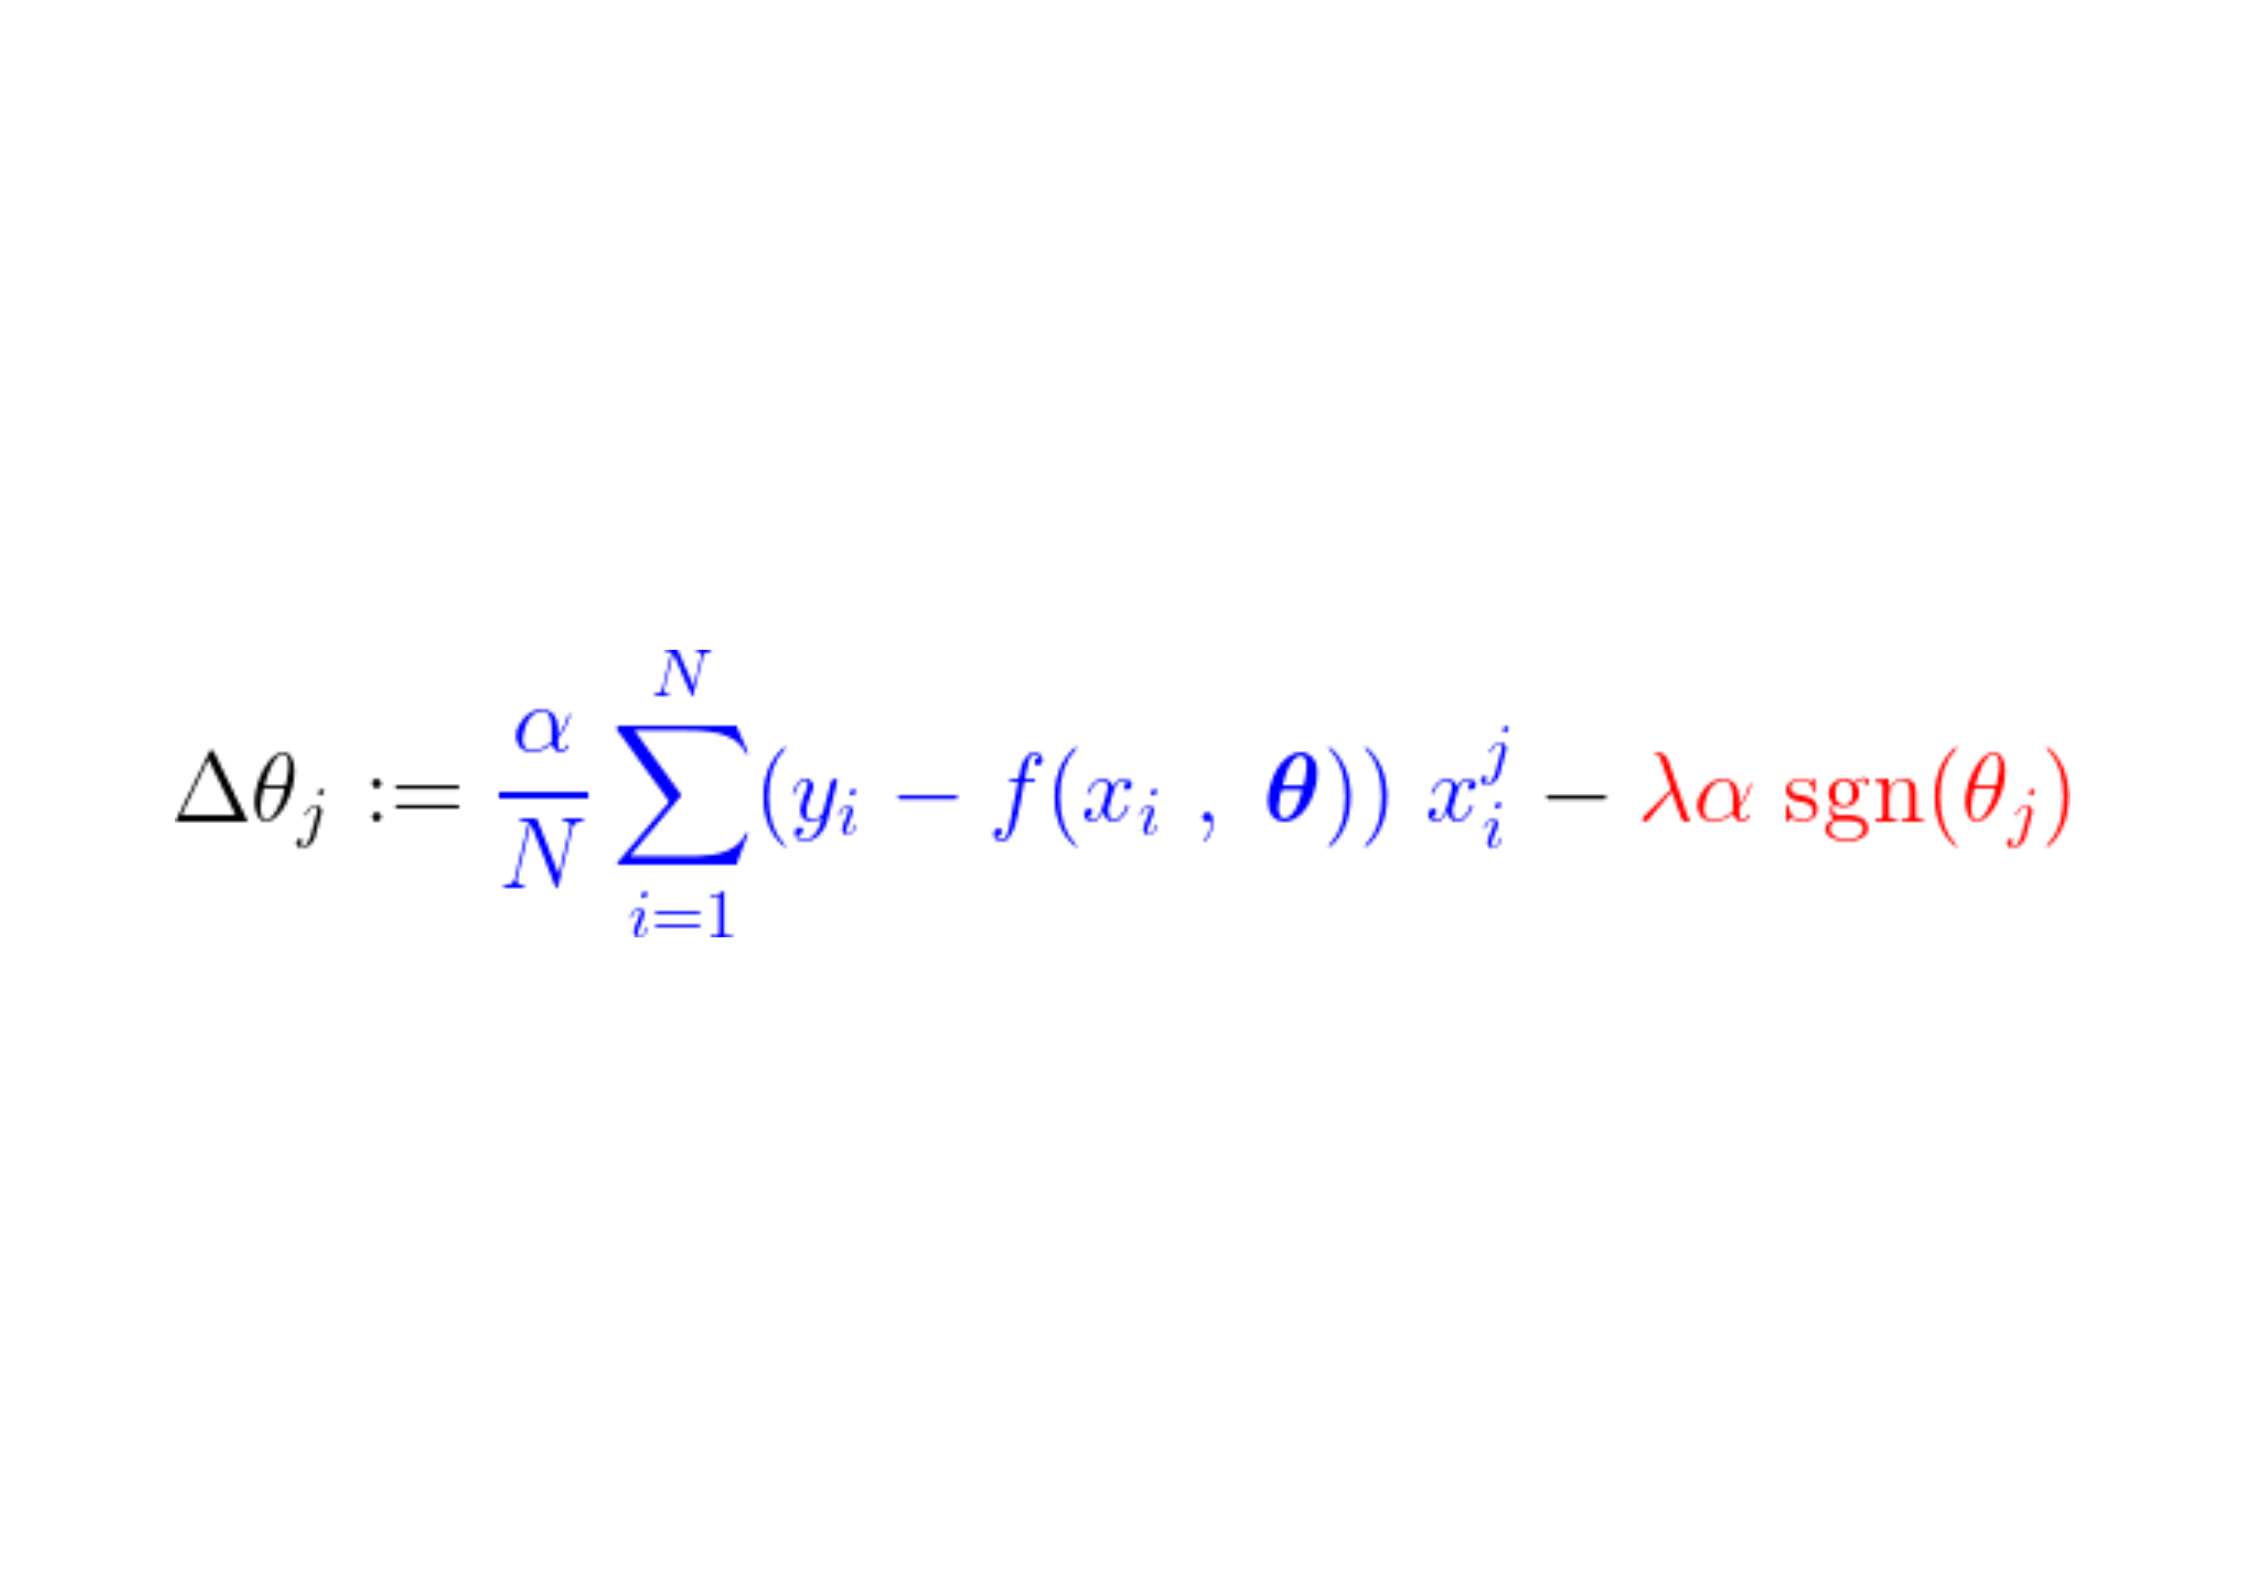
Os métodos embutidos identificam implicitamente características sem usar quaisquer critérios de seleção predefinidos e as extraem dos próprios dados de treinamento. Esse processo de identificação de características intrínsecas faz parte da fase de treinamento do modelo. O modelo aprende a identificar características e a fazer previsões relacionadas simultaneamente. Nas seções subsequentes, descreveremos o papel da regularização nesse processo de identificação de características intrínsecas, com foco na regularização L1 e seu papel na melhoria de modelos de aprendizado de máquina.
Normalização e Complexidade do Modelo: Estratégias Avançadas para Melhorar o Desempenho
Regularização é o processo de penalizar a complexidade do modelo para evitar overfitting e obter generalização para a tarefa.
Aqui, a complexidade do modelo é análoga à sua capacidade de se adaptar a padrões nos dados de treinamento. Supondo um modelo polinomial simples em ' x ' com grau ' d ', quanto maior o grau ' d ' do polinômio, mais flexível o modelo se torna na captura de padrões nos dados observados. Essa maior flexibilidade pode levar o modelo a memorizar os dados de treinamento em vez de aprender os padrões reais, reduzindo assim sua capacidade de generalização para novos dados.
Sobreajuste e subajuste
Ao tentar ajustar um modelo polinomial de grau d = 2 a um conjunto de amostras de treinamento derivadas de um polinômio de terceiro grau com algum ruído, o modelo não conseguirá capturar adequadamente a distribuição das amostras. O modelo simplesmente não possui a flexibilidade ou complexidade necessária para modelar dados gerados por polinômios de terceiro grau (ou superior). Diz-se que esse modelo está subajustado aos dados de treinamento. O subajuste indica que o modelo é muito simplista e não consegue capturar padrões subjacentes nos dados.
Continuando com o mesmo exemplo, vamos supor que temos um modelo com grau d = 6. Agora, com o aumento da complexidade, o modelo deve estimar facilmente o polinômio cúbico original usado para gerar os dados (por exemplo, definindo os coeficientes de todos os termos com expoentes > 3 como 0). Se o processo de treinamento não for interrompido a tempo, o modelo continuará usando sua flexibilidade extra para reduzir ainda mais o erro e começará a capturar também amostras de ruído. Isso reduzirá significativamente o erro de treinamento, mas o modelo agora sofre com a sobrecarga dos dados de treinamento. O ruído mudará em cenários do mundo real (ou durante os testes), e qualquer conhecimento baseado em previsões será comprometido, resultando em um alto erro de teste. Sobrecarga significa que o modelo é muito complexo e está aprendendo ruído em vez do sinal real.
Como determinar a complexidade ótima do modelo?
Em cenários práticos, muitas vezes temos compreensão limitada ou nenhuma do processo de geração de dados ou da verdadeira distribuição de dados. Encontrar o modelo ideal com a complexidade apropriada, para que não haja subajuste ou superajuste, é um desafio significativo. Isso requer o uso de métodos eficazes para avaliar o desempenho dos modelos e determinar a complexidade apropriada que alcance o melhor equilíbrio entre precisão e generalidade. Ao usar métricas e técnicas de avaliação apropriadas, como validação cruzada, os profissionais podem identificar o modelo que tem melhor desempenho em dados não vistos, evitando assim problemas de ajuste excessivo ou insuficiente.
Uma técnica possível é começar com um modelo suficientemente robusto e então reduzir sua complexidade por meio da seleção de recursos. Quanto menos recursos, menos complexo será o modelo.
Como discutimos na seção anterior, a seleção de recursos pode ser explícita (métodos de filtragem, métodos de convolução) ou implícita. Recursos redundantes que não são muito importantes na determinação do valor da variável de destino devem ser removidos para evitar que o modelo aprenda padrões não correlacionados neles. A regularização também executa uma tarefa semelhante. Então, como a regularização e a seleção de recursos se relacionam para atingir um objetivo comum de complexidade ideal do modelo? Reduzir a complexidade em modelos de aprendizado de máquina é crucial para melhorar o desempenho e evitar overfitting, que é o foco da regularização e da seleção de recursos.
Regularização L1 como determinante de característica
Continuando com nosso modelo polinomial, representamos ele como uma função de f, com entradas x , coeficientes θ e grau d ,
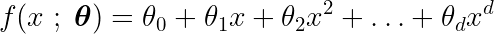
Para o modelo polinomial, cada potência da entrada x_i pode ser considerada uma característica, formando um vetor da seguinte forma:
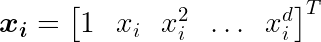
Definimos também uma função objetivo, cuja redução leva aos parâmetros ideais θ* e inclui o termo regularização , que penaliza a complexidade do modelo.
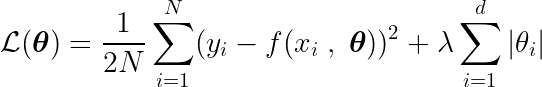
Para encontrar o mínimo desta função, precisamos analisar todos os pontos críticos, ou seja, os pontos onde a derivada é zero ou indefinida.
A derivada parcial em relação a um dos parâmetros, θj , pode ser escrita da seguinte forma:
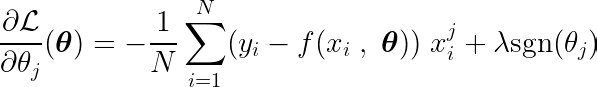
A função sgn é definida da seguinte forma:
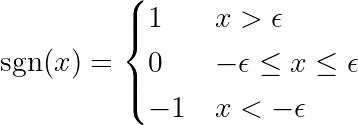
Nota : A derivada de uma função absoluta difere da função sinal (sgn) definida acima. A derivada original é indefinida em x = 0. Estendemos a definição para remover o ponto de inflexão em x = 0 e tornar a função diferenciável em todo o seu domínio. Além disso, frameworks de aprendizado de máquina (ML) utilizam essas funções estendidas quando operações aritméticas básicas envolvem a função absoluta. Confira este link no fórum do PyTorch.
Calculando a derivada parcial da função objetivo em relação a um único coeficiente θj e igualando-a a zero, podemos construir uma equação que relaciona o valor ótimo de θj com as previsões, os objetivos e as características.
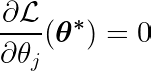
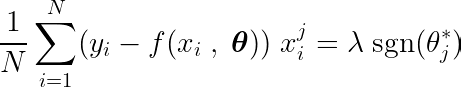
Vamos examinar a equação acima. Se assumirmos que as entradas e os alvos estavam centrados em torno da média (ou seja, que os dados foram padronizados na etapa de pré-processamento), então o termo do lado esquerdo (LHS) representa efetivamente a variância entre a característica número j e a diferença entre os valores esperados e os valores alvo.
A covariância estatística entre duas variáveis determina a quantidade de influência que uma variável tem sobre o valor da segunda variável (e vice-versa).
A função sinal no lado direito força a variância no lado esquerdo a assumir apenas três valores (já que a função sinal retorna apenas -1, 0 e 1). Se a característica j for desnecessária e não afetar as previsões, a variância será próxima de zero, o que torna o coeficiente correspondente θj* igual a zero. Isso resulta na remoção da característica do modelo. Esse processo ajuda a reduzir a complexidade e a melhorar o desempenho do modelo.
Imagine a função do sinal como um sulco esculpido pela água. Você pode caminhar até a ravina (ou seja, o leito do rio), mas para sair dela, você encontrará enormes barreiras ou corredeiras íngremes. A regularização L1 cria um efeito de “limiar” semelhante ao gradiente da função de perda. O gradiente deve ser forte o suficiente para quebrar as barreiras ou se tornar zero, eventualmente tornando o valor do coeficiente zero.
Para fornecer um exemplo mais realista, considere um conjunto de dados contendo amostras derivadas de uma linha reta (parametrizada em dois fatores) com algum ruído adicionado. O modelo ideal não deve ter mais de dois parâmetros, caso contrário, ele se ajustará excessivamente ao ruído nos dados (com a liberdade/poder adicional do polinômio). Alterar os coeficientes de potência mais altos em um modelo polinomial não afeta a diferença entre os alvos e as previsões do modelo e, portanto, reduz sua variância com o recurso.
Durante o processo de treinamento, um passo fixo é adicionado/subtraído do gradiente da função de perda. Se o gradiente da função de perda (MSE – erro quadrático médio) for menor que o passo constante, o coeficiente eventualmente atingirá um valor de 0. Observe a equação abaixo, que descreve como os coeficientes são atualizados usando a descida do gradiente:

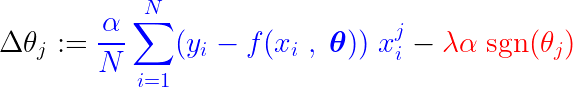
Se a parte azul acima for menor que λα , que por si só é um número muito pequeno, então Δθj é aproximadamente um passo constante de λα . O sinal desse passo (a parte vermelha) depende de sgn(θj) , cujo resultado depende de θj . Se o valor de θj for positivo, ou seja, maior que ε , então sgn(θj) é igual a 1, tornando Δθj aproximadamente igual a -λα , aproximando-o de zero.
Para suprimir o passo constante (parte vermelha) que torna o coeficiente zero, o gradiente da função de perda (parte azul) deve ser maior que o tamanho do passo. Para obter um gradiente maior para a função de perda, o valor do recurso deve afetar significativamente a saída do modelo.
É assim que o recurso, ou mais precisamente, seu parâmetro correspondente, cujo valor não está relacionado à saída do modelo, é zerado pela regularização L1 durante o treinamento.
Leituras adicionais e conclusão
- Para obter mais informações sobre este tópico, postei uma pergunta no Reddit r/MachineLearning eAcompanhamento Ele contém diferentes interpretações que você pode querer ler.
- Madiyar Aitbayev também tem blog interessante Abrange a mesma questão, mas com uma explicação de engenharia.
- Blog Brian King explica a organização de uma perspectiva probabilística.
- Isto النقاش No site CrossValidated, ele explica por que o critério L1 incentiva modelos esparsos. Blog Um artigo detalhado de Mukul Ranjan explica por que a norma L1 incentiva as transações a se tornarem zero e a norma L2 não.
"A regularização L1 seleciona recursos" é uma afirmação simples com a qual a maioria dos aprendizes de aprendizado de máquina concorda, sem se aprofundar em seu funcionamento interno. Este blog é uma tentativa de compartilhar meu entendimento e modelo mental com os leitores para responder à pergunta de forma intuitiva. Para sugestões e perguntas, você pode encontrar meu endereço de e-mail no meu site . Continue aprendendo e tenha um ótimo dia!
Comentários estão fechados.