

Classificação do público: 27 modelos de IA, ChatGPT em 8º lugar – Aqui estão os modelos que o superaram

Embora o mundo da inteligência artificial (IA) possa muitas vezes parecer uma área turbulenta, uma quantidade surpreendente de análises, medições de desempenho e testes ocorre nos bastidores. Isso não é feito apenas pelas próprias empresas, mas também por grupos criados para determinar seus próprios rankings.
Esses grupos testam tudo, desde a capacidade de um chatbot de concluir testes de matemática,
Crie imagens, ou fornecer explicações lógicas, ou até mesmo dar conselhos médicos, ou simplesmente mostrar o quão emocionalmente inteligente ela é.
Durante esses diversos testes, os modelos revelam seus pontos fortes e fracos em diferentes áreas. Por exemplo, embora o GPT-5 se destaque na dedução científica, ele fica atrás de modelos como Gemini e Claude em sua capacidade de se adaptar a novos conceitos.
Cada um desses testes nos revela algo novo sobre modelos de IA e são importantes para nos lembrar quais ferramentas são melhores em diferentes cenários. Mas muitas vezes falta uma métrica: quais modelos de IA proporcionam a melhor experiência do usuário?
Sistema de classificação humana
Uma empresa de tecnologia sediada no Reino Unido chamada Prolific criou um ranking de IA chamado Humaine . Em vez de testar a capacidade da IA de concluir tarefas, a Prolific testou diferentes experiências de usuário com esses modelos.
Ao avaliar as experiências de 21,352 pessoas com as ferramentas, eles não só conseguiram encontrar um vencedor geral, mas também dividir os resultados por idade, localização (os testes foram feitos no Reino Unido e nos EUA) e crenças políticas.
Isso inclui listagens individuais para:
- Reino Unido: Faixas etárias
- Reino Unido: Raça
- Reino Unido: Ponto de vista político
- Estados Unidos: Faixas etárias
- Estados Unidos: Raça
- Estados Unidos: Ponto de vista político
A equipe fez com que cada participante interagisse com dois modelos de IA separados em uma comparação e pediu que eles fornecessem feedback sobre qual modelo teve melhor desempenho em cada interação.
Isso resultou em um vencedor geral e uma tabela de classificação para desempenho, mas também classificações separadas para desempenho de tarefas básicas e raciocínio, bem como um vencedor para comunicação, resiliência, confiança e ética.
O que os resultados mostram?
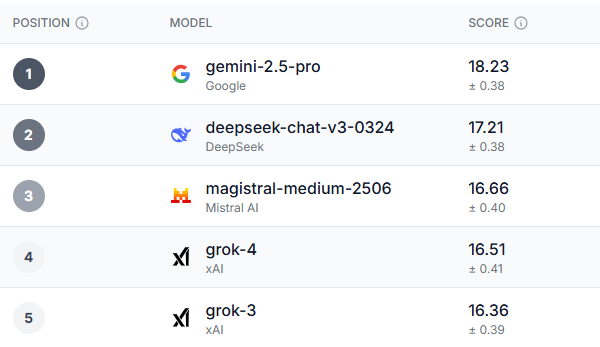
Após uma análise completa, surgiu um vencedor claro, não apenas na categoria de desempenho geral, mas também na maioria das subcategorias. O Gemini 2.5-Pro se destacou em quase todos os benchmarks analisados no teste.
Jovens adultos de 18 a 34 anos no Reino Unido, eleitores democratas e pessoas com mais de 55 anos nos EUA concordaram que o Gemini 2.5 Pro era o melhor modelo no geral. A única área em que todos os grupos demográficos o classificaram acima do Gemini foi em confiança, ética e segurança, e essa foi a do Grok-3 — uma descoberta um tanto irônica, considerando alguns dos problemas de segurança e ética que o modelo de IA enfrentou recentemente.
Curiosamente, os três modelos que surgiram depois do Gemini são Deepseek, Magistral Le Chat e Grok . Embora o Deepseek tenha alcançado grande popularidade no início deste ano, recentemente perdeu destaque. O Le Chat, por outro lado, é um chatbot menos popular, mas possui uma base de usuários fiéis.
Então, onde se encaixa o mundialmente famoso ChatGPT nisso tudo? Ele está no final da lista, em oitavo lugar com seu modelo GPT-4.1. Pior ainda é o Claude , cujas duas versões (4.0 e 4.0) ficaram em décimo primeiro e décimo segundo lugar no geral.
Então, o que tudo isso significa?
Isso significa que o Gemini é o melhor chatbot de IA do mundo? Significa que você deveria abandonar o ChatGPT…? Bem, não exatamente.
Esses resultados não refletem necessariamente o desempenho desses modelos. Quando testados com a maioria das outras métricas, as opções que normalmente vemos no topo são ChatGPT, Gemini, Claude e Grok.
No entanto, este é um acréscimo importante a esses testes. Eles nos ajudam a entender melhor a IA sob a perspectiva da experiência humana. Por exemplo, o Le Chat não obtém uma pontuação alta em benchmarks padrão, mas é frequentemente citado como uma excelente escolha em termos de experiência e confiabilidade.
Embora o desempenho da Anthropic e da OpenAI não tenha atingido esse nível nesta rodada de testes, foi mais um desempenho sólido para a Gemini e a Grok. Ambas as empresas frequentemente alcançam pontuações altas em benchmarks padrão, e continuaram a fazê-lo aqui também.

Comentários estão fechados.